La dette technique est l’un des sujets les plus mal compris dans les organisations — et pourtant l’un des plus impactants sur la capacité à mener des projets SI. Rares sont les transformations qui réussissent sans que la question de la dette technique ne se pose, à un moment ou à un autre, avec acuité. Le refactoring est systématiquement repoussé, les équipes techniques s’épuisent sur des contournements, et le métier ne comprend pas pourquoi les livraisons sont toujours en retard.
La gestion de la dette technique est un exercice d’équilibriste. D’un côté, les équipes de développement réclament du temps pour nettoyer le code, refondre les architectures vieillissantes et moderniser les composants obsolètes. De l’autre, les métiers veulent des fonctionnalités, des évolutions et des corrections — maintenant, pas dans six mois. La direction de projet est au milieu, devant arbitrer sans toujours disposer des éléments objectifs pour le faire.
Cet article propose une approche pragmatique pour diagnostiquer, quantifier, prioriser et communiquer autour de la dette technique. L’objectif n’est pas de l’éliminer — ce serait illusoire — mais de la rendre visible, gérable et intégrée dans le pilotage normal des projets SI. C’est un changement de paradigme qui, une fois adopté, transforme durablement la relation entre IT et métiers.
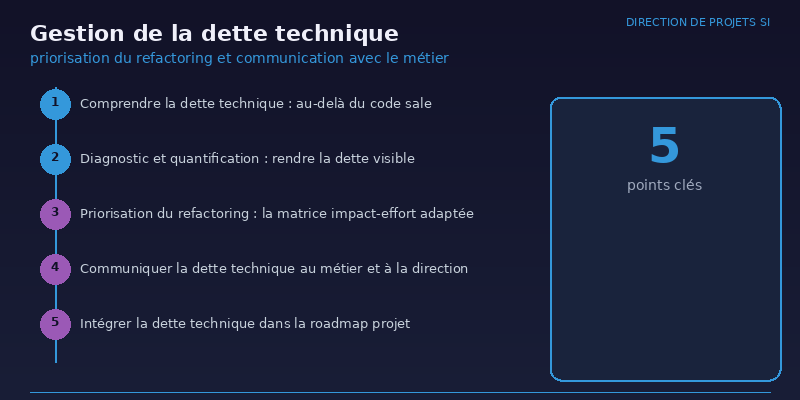
Comprendre la dette technique : au-delà du code sale
La métaphore de la dette technique, introduite par Ward Cunningham, compare le code de mauvaise qualité à une dette financière : on emprunte du temps aujourd’hui (en prenant des raccourcis techniques) qu’on devra rembourser demain (avec des intérêts sous forme de coûts de maintenance accrus). Mais cette définition originelle est trop étroite. La dette technique englobe en réalité plusieurs dimensions.
La dette de code est la plus visible : code dupliqué, fonctions trop complexes, absence de tests unitaires, conventions non respectées. Elle se mesure avec des outils d’analyse statique (SonarQube, par exemple) et se corrige par du refactoring ciblé.
La dette d’architecture est plus profonde : composants monolithiques qui auraient dû être découplés, dépendances circulaires entre modules, absence de couche d’abstraction. Elle nécessite des chantiers de refonte plus lourds et plus risqués. La gestion des interfaces API en projet de transformation est souvent le révélateur d’une dette architecturale accumulée.
La dette d’infrastructure concerne les environnements techniques : versions obsolètes de frameworks ou de systèmes d’exploitation, serveurs sous-dimensionnés, absence d’automatisation des déploiements. Elle est souvent invisible jusqu’au jour où un incident majeur la révèle brutalement.
La dette de documentation — spécifications absentes ou obsolètes, absence de cartographie des flux, processus non documentés — est peut-être la plus insidieuse. Elle ralentit l’intégration des nouveaux développeurs, complique les diagnostics d’incidents et rend les estimations de charge imprécises.
La dette de compétences, enfin, survient quand les technologies utilisées ne sont plus maîtrisées par les équipes en place. Des langages ou frameworks que plus personne ne connaît, des modules maintenus par un seul expert qui pourrait partir — c’est un risque opérationnel majeur souvent ignoré dans les comités de direction.
Diagnostic et quantification : rendre la dette visible
Le premier défi de la gestion de la dette technique est de la rendre visible et compréhensible par toutes les parties prenantes, y compris les non-techniques. Tant qu’elle reste un concept abstrait que seuls les développeurs évoquent entre eux, elle ne sera jamais priorisée au même niveau que les demandes fonctionnelles.
La cartographie de la dette est l’exercice fondateur. Il s’agit de recenser systématiquement les éléments de dette technique, de les catégoriser (code, architecture, infrastructure, documentation, compétences) et de les localiser dans le système d’information. Pour chaque élément, on évalue deux dimensions : l’impact (que se passe-t-il si on ne le traite pas ?) et l’effort (combien de temps pour le corriger ?).
Plusieurs méthodes de quantification existent. La plus intuitive est la quantification en jours/homme : combien de temps de développement faudrait-il pour rembourser cette dette ? C’est parlant pour les équipes techniques mais insuffisant pour le métier. La quantification en coût financier est plus efficace pour les comités de direction : combien nous coûte cette dette par mois en maintenance supplémentaire, en incidents, en retards de livraison ? La distinction entre KPIs projet et KPIs business prend ici tout son sens.
Le ratio dette/valeur est un indicateur particulièrement utile. Comme le décrit le framework PRINCE2, Pour chaque composant du SI, calculez le ratio entre le temps passé en maintenance corrective (intérêts de la dette) et le temps passé en développement de nouvelles fonctionnalités (création de valeur). Un composant où 70 % du temps est consacré à la maintenance est un candidat prioritaire au refactoring.
L’outil de sortie de ce diagnostic est un registre de dette technique, analogue au registre de risques d’un projet. Chaque élément de dette est documenté avec sa catégorie, sa localisation, son impact estimé, son effort de correction et son propriétaire. Ce registre est la base de toute discussion de priorisation.
Priorisation du refactoring : la matrice impact-effort adaptée
Avec un registre de dette technique qui peut contenir des dizaines voire des centaines d’éléments, la question de la priorisation devient critique. On ne peut pas tout traiter en même temps, et le budget temps consacré au refactoring est structurellement limité — il faut le dépenser là où il a le plus d’impact.
La matrice impact-effort est l’outil de priorisation le plus utilisé, et à juste titre. En abscisse, l’effort de correction (de faible à élevé). En ordonnée, l’impact négatif de la dette (de faible à critique). Les quatre quadrants donnent une stratégie claire : les éléments à fort impact et faible effort sont les quick wins à traiter immédiatement. Les éléments à fort impact et fort effort nécessitent des chantiers planifiés. Les éléments à faible impact sont soit des opportunismes (faible effort) soit des éléments à accepter consciemment (fort effort).
J’ajoute systématiquement une troisième dimension : le risque d’aggravation. Certaines dettes techniques sont stables — elles ne s’aggravent pas si on ne les traite pas. D’autres sont progressives — elles empirent avec le temps (un framework de plus en plus obsolète, par exemple). Et certaines sont explosives — elles peuvent provoquer un incident majeur à tout moment. Cette dimension change radicalement l’ordre des priorités.
La règle pragmatique que j’applique en pilotage de projet est la règle du 20/80 adaptée : consacrer 20 % de chaque sprint ou de chaque itération au traitement de la dette technique. Cette allocation fixe évite le débat récurrent « fonctionnalité vs refactoring » et normalise le fait que le maintien de la qualité technique fait partie du travail courant, pas d’un projet exceptionnel. La gestion de portefeuille et la priorisation s’appliquent autant au backlog technique qu’au backlog fonctionnel.
Communiquer la dette technique au métier et à la direction
L’un des plus grands échecs des équipes techniques est de ne pas réussir à expliquer la dette technique en termes compréhensibles par le métier. Les discours sur le « code legacy », les « dépendances circulaires » ou le « manque de couverture de tests » n’ont aucune résonance pour un directeur financier ou un responsable métier.
La communication doit reposer sur trois piliers. Le premier est la traduction en impact business. Ne dites pas « notre code est sale », dites « chaque nouvelle fonctionnalité prend trois fois plus de temps qu’elle ne devrait à cause de la complexité accumulée dans le système ». Ne dites pas « on a besoin de refactorer l’architecture », dites « le risque d’interruption de service est de X % par mois et augmente de Y % chaque trimestre ». Le reporting COMEX doit intégrer ces métriques en langage business.
Le deuxième pilier est la visualisation. Un graphique montrant l’évolution du ratio maintenance/développement sur 12 mois est plus éloquent qu’une page de texte. Une carte thermique des composants du SI colorée selon leur niveau de dette parle à tout le monde. Un burndown chart de la dette technique montre les progrès réalisés. Les outils visuels transforment un concept abstrait en réalité tangible.
Le troisième pilier est l’analogie. La métaphore de la dette financière est puissante : « Nous avons emprunté de la qualité technique pour livrer plus vite. Les intérêts de cette dette nous coûtent maintenant X jours par mois. Si nous ne remboursons pas progressivement, les intérêts finiront par absorber toute notre capacité de développement. » Cette analogie parle à tous les profils de direction.
Un piège à éviter absolument : ne jamais utiliser la dette technique comme excuse pour des retards ou des problèmes de livraison. C’est la meilleure façon de perdre la crédibilité auprès du métier. La dette technique est un facteur parmi d’autres, et la responsabilité de la gérer appartient aussi à la direction technique qui l’a laissée s’accumuler.
Intégrer la dette technique dans la roadmap projet
La dette technique ne peut plus être un sujet parallèle, traité « quand on a le temps » (c’est-à-dire jamais). Elle doit être intégrée nativement dans la roadmap du projet et du système d’information.
Concrètement, cela signifie que le backlog de refactoring est géré avec les mêmes outils et les mêmes processus que le backlog fonctionnel. Comme le décrit le méthodologie ITIL, Chaque élément de dette technique est une user story (ou un technical story) avec une définition de terminé, une estimation et un critère d’acceptation. Ces stories participent à la planification des sprints au même titre que les stories fonctionnelles.
La roadmap à double flux est un format de planification que je recommande systématiquement. Sur un même diagramme, on visualise les livraisons fonctionnelles (en bleu) et les chantiers de refactoring (en orange). Cela montre explicitement comment le temps est réparti et permet des discussions éclairées sur les arbitrages. C’est un outil de transparence qui restaure la confiance entre les équipes techniques et les parties prenantes métier.
Pour les chantiers de refactoring majeurs — refonte d’un module, migration d’un framework, remplacement d’un composant — la planification doit intégrer une dimension de gestion des risques projet spécifique. Le refactoring comporte des risques de régression, de perte de fonctionnalité et de déstabilisation. Un plan de test renforcé, des déploiements progressifs et des points de non-retour clairement identifiés sont indispensables.
La question des dépendances entre refactoring et fonctionnel est également cruciale. Parfois, il faut refactorer un composant avant de pouvoir y ajouter une fonctionnalité demandée par le métier. Dans ce cas, le refactoring devient un prérequis explicite, ce qui facilite son acceptation. Parfois, au contraire, le refactoring peut se faire indépendamment — il est alors plus facile à planifier mais aussi plus facile à repousser.
Stratégies de réduction progressive : les approches qui fonctionnent
Plusieurs stratégies de réduction de la dette technique ont fait leurs preuves en contexte projet. Le choix dépend de la nature de la dette, de la maturité de l’organisation et du contexte projet.
La stratégie du boy scout rule — « laissez le code plus propre que vous ne l’avez trouvé » — est la plus légère. Chaque développeur, lorsqu’il intervient sur un fichier pour une évolution ou une correction, prend quelques minutes pour améliorer ce qu’il touche : renommer une variable obscure, extraire une méthode, ajouter un test unitaire. Cumulé sur des dizaines d’interventions quotidiennes, l’effet est significatif sans jamais impacter le planning.
La stratégie du refactoring opportuniste consiste à coupler systématiquement les chantiers de refactoring avec les évolutions fonctionnelles. Quand le métier demande une évolution sur un composant qui porte de la dette, l’estimation inclut le refactoring nécessaire. Le surcoût est marginal (10-20 %) par rapport à une refonte complète ultérieure, et le métier y gagne un composant plus robuste et plus évolutif. La estimation des charges projet doit systématiquement intégrer cette marge.
La stratégie du chantier dédié s’impose pour les dettes majeures qui ne peuvent pas être absorbées par les approches précédentes : migration de framework, refonte d’architecture, remplacement d’un composant critique. Ces chantiers doivent être traités comme de vrais projets, avec un budget, un planning, une équipe et un suivi.
La stratégie de la réécriture partielle est parfois nécessaire quand la dette est si profonde que le refactoring n’est plus viable. C’est la décision la plus difficile — et la plus risquée. Elle nécessite une analyse rigoureuse du coût total de possession (TCO) : est-il réellement moins cher de réécrire que de continuer à maintenir ? Les projets de réécriture complète ont un taux d’échec élevé ; la réécriture par pans successifs (strangler fig pattern) est généralement plus sûre.
Quelle que soit la stratégie choisie, le suivi dans le temps est essentiel. Un tableau de bord de la dette technique avec des indicateurs d’évolution (la dette diminue-t-elle ? les intérêts baissent-ils ?) permet de valider que les efforts portent leurs fruits et de maintenir la mobilisation de l’organisation sur le sujet.
La direction de projets SI est un domaine où l’expérience terrain fait toute la différence. Si vous souhaitez échanger sur votre situation, contactez-moi.
📚 Retrouvez tous nos articles sur ce thème : Direction de Projets SI
Articles connexes
- Spécifications techniques vs métier : cadre de formalisation
- Coordination multi-prestataires IT : contrats, KPIs et clauses pénales
- Planification projet : les illusions du planning et comment construire un calendrier réaliste
- Digitalisation des processus opérationnels : piloter l’automatisation
Approfondir le sujet